מכונה שמנחשת את הטוקן הבא
מודל שפה גדול, המנוע שבתוך צ’טבוט, עושה דבר אחד שוב ושוב: בהינתן טקסט, הוא נותן הסתברות לכל חתיכת טקסט אפשרית שיכולה לבוא אחריו. חתיכה אחת נבחרת ומתווספת לסוף, וכל הטקסט חוזר פנימה כדי לבחור את החתיכה שאחריה. תשובה של מאה מילים דורשת הרבה יותר ממאה צעדים כאלה.
החתיכות האלה הן טוקנים. הטוקנייזר חותך טקסט לפי אוצר קבוע של טוקנים, בדרך כלל כמה עשרות אלפים ועד כמה מאות אלפים מהם. מילים נפוצות הן טוקן אחד כל אחת, ובדרך כלל כולל הרווח שלפניהן; מילים נדירות יותר נחתכות לחלקים. מילה מומצאת כמו zorblat נחתכת ל־zor ול־blat. לכל טוקן באוצר יש מספר, והמודל אף פעם לא רואה אותיות, רק את המספרים האלה.
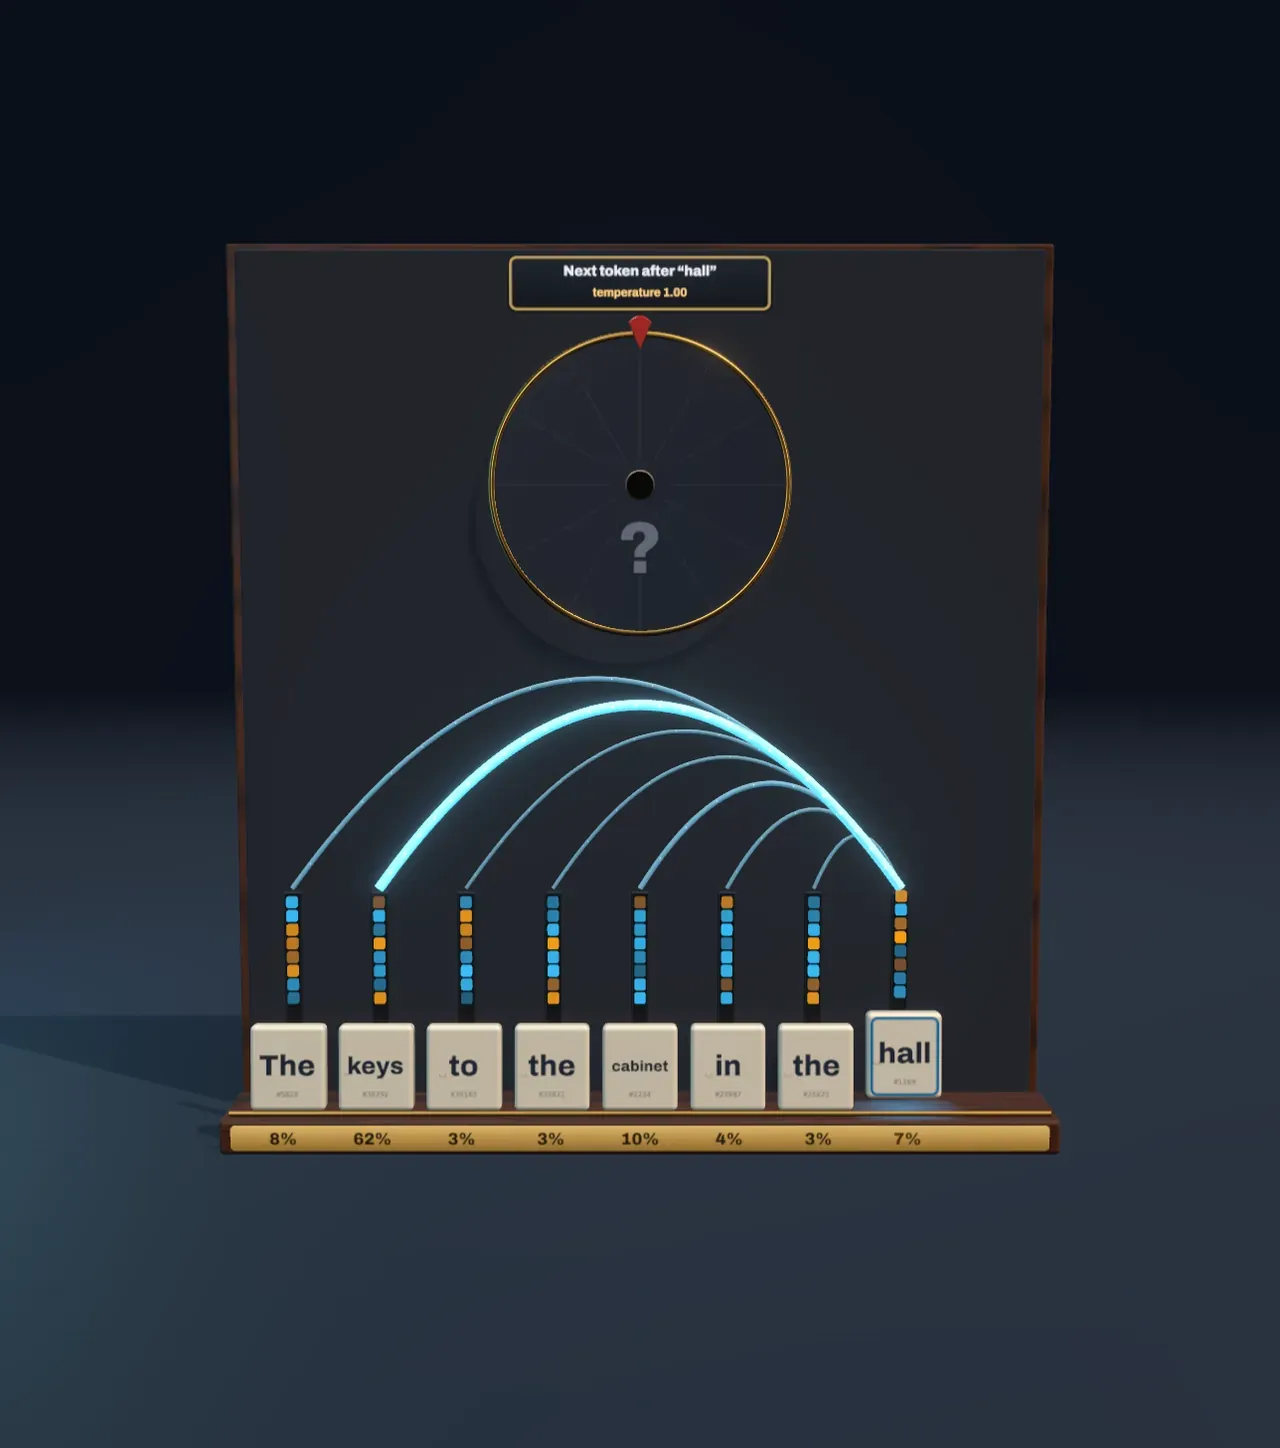
כל מספר של טוקן נשלף אחר כך מטבלה שנותנת לו רשימה ארוכה של מספרים, הווקטור שלו: ממאות ועד יותר מעשרת אלפים מספרים במודל גדול. הסצנה מראה שמונה, כעמודה של תאים מוארים מאחורי כל אריח: כחול למספר חיובי, ענבר למספר שלילי. אותו טוקן מתחיל תמיד עם אותו וקטור, ולכן לשני העותקים של the במשפט הראשון יש עמודות זהות. האימון סידר את הווקטורים האלה כך שלטוקנים שמשמשים בדרכים דומות יש וקטורים דומים.
נסו: הזיזו את מעקב אחר הקשב אל טוקנים וקראו את האריחים. הסימן ␣ החיוור על אריח הוא הרווח שהטוקן נושא, והמספר שמתחת למילה הוא המקום שלו באוצר הטוקנים.
קשב: מסתכלים אחורה על המילים החשובות
כדי לנחש מה בא אחרי The keys to the cabinet in the hall, המודל צריך לדעת שהמשפט עוסק ב־keys, המפתחות. שמות העצם הקרובים, cabinet ו־hall, הם הלא נכונים: המילה הבאה הרבה יותר צפויה להיות are מאשר is. מודל שמסתכל רק על המילה האחרונה או שתיים היה טועה כאן.
קשב הוא הדרך שבה טוקן אוסף את מה שהוא צריך מהטוקנים שלפניו. כל טוקן מייצר מהווקטור שלו שלושה וקטורים: שאילתה (מה אני מחפש?), מפתח (מה אני מציע?) וערך (מה אעביר הלאה). הטוקן המתבונן משווה את השאילתה שלו למפתח של כל טוקן קודם, וככל שההתאמה טובה יותר הציון גבוה יותר. הציונים הופכים לחלקים שמסתכמים ב־100% (פונקציית softmax), והטוקן לוקח את החלק הזה מהערך של כל טוקן קודם ומוסיף את התערובת לווקטור שלו.
בסצנה, האריח המורם הוא הטוקן המתבונן. כל קשת חוזרת אל טוקן קודם, ועובייה הוא חלק הקשב שהטוקן הזה מקבל; רצועת הפליז שמתחת לאריחים מדפיסה את החלקים. העמודה של הטוקן המתבונן משנה צבע כשהתערובת מגיעה: עכשיו היא נושאת מידע מהמילים שהוא הסתכל עליהן.
נסו: במשפט בחרו The keys…, והזיזו את הטוקן המתבונן עד 8, הטוקן האחרון, וראו איך hall שולח את רוב הקשב שלו מעבר ל־cabinet אל keys. אחר כך הזיזו את הטוקן המתבונן צעד אחר צעד אחורה, וראו את הקשתות מתארגנות מחדש.
הזכוכית הכהה מכסה את הטוקנים שאחרי הטוקן המתבונן. מודל שפה שכותב משמאל לימין רשאי רק להסתכל אחורה: באימון אסור לו להציץ במילה שהוא לומד לחזות. זו המסכה הסיבתית.
ראש אחד, הרבה תפקידים
הסצנה מראה ראש קשב אחד. מודל אמיתי מריץ בכל שכבה הרבה ראשים זה לצד זה, ולכל אחד דרך משלו לייצר שאילתות, מפתחות וערכים, כך שכל אחד לומד לחפש משהו אחר. שלושת המשפטים מראים שלושה סוגי הסתכלות שחוקרים מצאו במודלים מאומנים:
- התאמה. ב־The keys to the cabinet in the hall, ראש שעוקב אחרי הנושא מאפשר למודל לבחור are, שמתאים ל־keys.
- שליפה. ב־The Eiffel Tower is in the city of, הטוקן האחרון אוסף את Eiffel ואת Tower. הקשב רק מקבץ את הרמז; התשובה, Paris, באה ממה ששאר הרשת למדה על העולם באימון.
- העתקה. ב־My pet zorblat sleeps. The zor, שום מודל לא למד מעולם את המילה zorblat. הראש מוצא את ה־zor הקודם ומסתכל על הטוקן שבא אחריו, וכך המודל יכול להעתיק את blat. ראשים שעושים את זה נקראים ראשי אינדוקציה, והם אחת הסיבות לכך שמודלים יכולים להשתמש בשמות ובמונחים שהם פוגשים לראשונה בהנחיה.
גם שאר המקומות חשובים. באימון המודל מנחש את הטוקן הבא בכל מקום במשפט בבת אחת, ומקבל ציון לפי ההסתברות שנתן לטוקן שבאמת הגיע. בתחילת משפט הוא לא יכול לדעת הרבה: אחרי The המילה הבאה האמיתית, keys, מקבלת פחות מ־0.1%.
מהסתברויות לבחירה
אחרי שהקשב ושאר הרשת סיימו את עבודתם, למודל יש ציון לכל טוקן באוצר שלו. ה־softmax הופך את הציונים להסתברויות. בסצנה הן הפלחים של הגלגל: פלח גדול לטוקן סביר, ופלח אפור ומקווקו לזנב הארוך של כל שאר הטוקנים, אלף רסיסים דקים מכדי לצייר כל אחד לחוד.
המודל לא חייב לקחת את הטוקן הסביר ביותר. דוגם מסובב את הגלגל. הטמפרטורה משנה את הגלגל לפני הסיבוב: כל ציון מחולק בטמפרטורה לפני ה־softmax. מתחת ל־1 הפלחים הגדולים גדלים והקטנים מצטמקים, כך שהמודל משחק בטוח וחוזר על עצמו יותר. מעל 1 הפלחים מתאזנים, ומפני שבזנב יש כל כך הרבה טוקנים, הוא משתלט מהר והטקסט הופך לשטויות. מערכות צ’ט רבות דוגמות בטמפרטורה שבין 0.5 ל־1 בערך, ולעתים קרובות גם חותכות קודם את הזנב.
נסו: הזיזו את מעקב אחר הקשב אל הטוקן הבא והורידו את הטמפרטורה ל־0.2, ואז העלו אותה ל־1.6. המחוג נשאר באותו מקום על הגלגל, אבל הפלחים זזים מתחתיו, והבחירה שמופיעה על האריח הזוהר משתנה.
התרשים שליד הסצנה מפרט את ההסתברויות, מסמן בכוכב את המילה הבאה האמיתית ואומר כמה הסתברות היא קיבלה. את המספר הזה האימון משפר. ההפתעה הממוצעת מהטוקן הבא האמיתי, בביטים, היא האנטרופיה הצולבת של המודל, אותו גודל כמו במידע ואנטרופיה.
מראש אחד למודל שפה גדול
טרנספורמר, המבנה שחוקרים בגוגל הציגו ב־2017 ושכמעט כל מודל שפה גדול מאז משתמש בו, חוזר על הצעד הזה פעמים רבות. בכל שכבה יש הרבה ראשי קשב ואחריהם רשת קטנה שעובדת על כל טוקן לחוד, וכל שכבה מוסיפה את התוצאה שלה לווקטור של הטוקן, כך שהווקטור אוסף עוד ועוד הקשר בדרכו למעלה. ל־GPT-3, מ־2020, היו 96 שכבות של 96 ראשים ו־175 מיליארד מספרים מתכווננים, הפרמטרים שלו. המספרים האלה מתחילים אקראיים ומכווננים בירידה במורד השיפוע, כמו ברשתות נוירונים, על פני טריליוני טוקנים של טקסט.
התוצאה היא מודל שטוב מאוד בהמשכת טקסט בצורה סבירה. זה לא אותו דבר כמו לצדוק. מודל שלמד איך נשמעת תשובה בטוחה בעצמה יכול לייצר תשובה רהוטה ושגויה, וזה נקרא הזיה. עוזרי צ’ט מאומנים עוד על דוגמאות של שיחות מועילות ועל דירוגים של אנשים לתשובות שלהם, אבל מתחת לכל זה הם עדיין בוחרים טוקן אחד בכל פעם.
לקשב יש מחיר. כל טוקן משווה את עצמו לכל טוקן שלפניו, ולכן הכפלת אורך הטקסט מכפילה את העבודה הזאת בערך פי ארבעה. זו הסיבה שלמודל יש חלון הקשר, גבול לכמות הטקסט שהוא יכול להסתכל עליה בבת אחת, ושקשה להאריך אותו.
מה המודל הזה משמיט
המשקלים, ההסתברויות, מספרי הטוקנים והווקטורים בסצנה נבנו ביד כדי להיראות כמו מה שמודל גדול עושה; שום מודל לא חישב אותם. למודל אמיתי יש הרבה ראשים בכל אחת מעשרות שכבות, ומה שראש בודד עושה הוא לעתים קרובות פחות מסודר מהדוגמאות האלה. לווקטורים אמיתיים יש מאות עד אלפי מספרים, לא שמונה, וכל ראש משווה ומערבב גרסאות מותמרות שלהם ולא את העמודות הגולמיות שבסצנה. הסצנה משמיטה את המקום של כל טוקן, שמודלים אמיתיים מוסיפים לווקטור שלו כדי שסדר המילים ייחשב. הזנב הארוך של הגלגל מצויר כאלף טוקנים לא סבירים במידה שווה, ואילו באוצר אמיתי של עשרות אלפי טוקנים הסיכויים שלהם שונים מאוד, ודוגמים אמיתיים בדרך כלל חותכים את הזנב לפני הסיבוב. המשפטים באנגלית; טקסט בעברית נחתך בדרך כלל ליותר טוקנים, וקצרים יותר.